LLMのトークンがコードから知識へ移りつつある。2026年4月3日にAndrej KarpathyがXに投稿したポストは、数日のうちにHacker Newsの上位に上がった。彼はLLMで関心のあるテーマの個人知識ベースを作っているとして、こう書いた。
“In this way, a large fraction of my recent token throughput is going less into manipulating code, and more into manipulating knowledge.”
こうすることで、最近の自分のトークン使用量のかなりの部分が、コードを扱うことから知識を扱うことへ移りつつある。
#三つのディレクトリと三つの動作
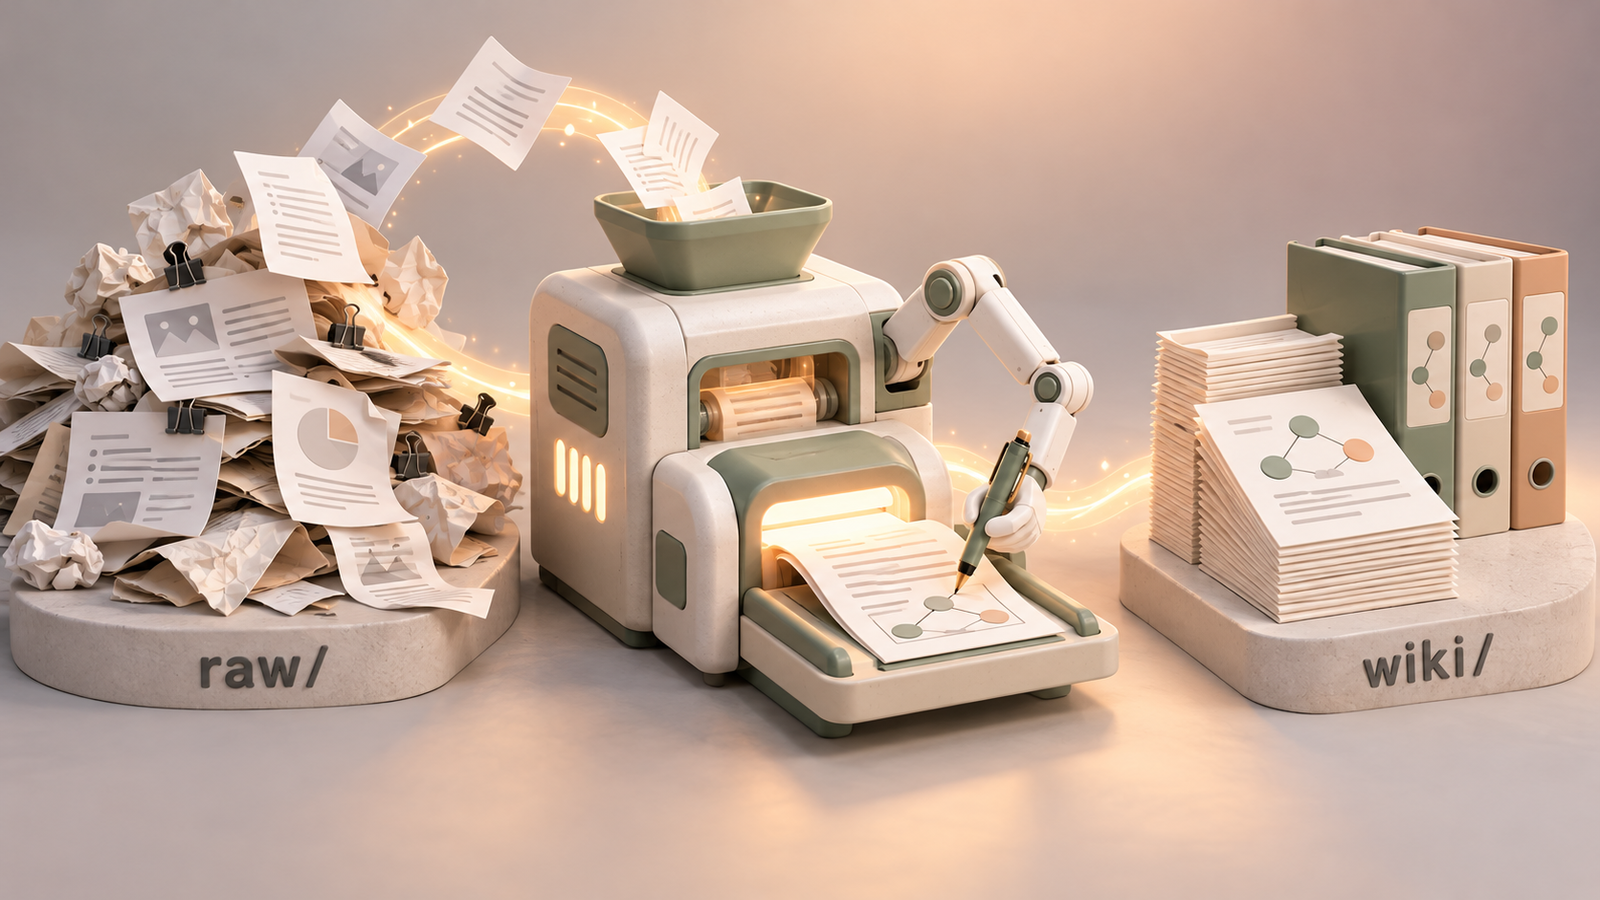
彼のシステムはraw、wiki、outputの三つのディレクトリに分かれる。ソースコードからバイナリを取り出すように、LLMが原資料から構造化された知識を取り出す構造だ。
rawにはWeb記事、PDF、データセット、論文をそのまま置き、一度入れたら直しも消しもしない。すべてのコンパイルの基盤なので、原本を失えば作り直せないからだ。wikiには概念ページ、エンティティのプロフィール、要約、相互参照が積み上がる。中心には、すべてのページの一行要約を集めたindex.mdと、いつ何が入ってきたかを書く追記専用の年代記log.mdがある。
構造はGistで公開されていて、CLAUDE.mdやAGENTS.mdがLLMにウィキの構造と作業の順序を指示する。このスキーマを書くことは、自分のドメインをどう構造化するかを決めることそのものだ。
ウィキが一度作られて終わりの文書集だったなら、静的なアーカイブにとどまっただろう。このシステムが違うのは、三つの動作が繰り返されてウィキが変わり続けるからだ。
- インジェスト:新しいソースを
rawに入れると、LLMが読んで要約した後、関連ページを直す。ソース一つが10から15ページに触れることもある。彼はObsidian Web ClipperでWeb記事をマークダウンに変換して入れている。PDFはDoclingやMarkerのような変換器を通せばいい。 - クエリ:ウィキに質問を投げると、LLMが
index.mdから関連ページを見つけて読み、相互参照しながら答えを合成する。回答、スライド、チャートがoutputに積まれ、使える結果はwikiに戻し入れる。 - リント:LLMがウィキ全体を見渡して、ページ間の矛盾、欠けた相互参照、古くなった情報、新しい記事の候補を見つけ出す。コードにリンターがあるように、知識にもリンターがある。
インジェストで知識を入れ、クエリの結果をウィキに加え、リントで誤りを直す。この循環が繰り返されるほど、ウィキは静的なアーカイブから生きたシステムへ変わる。
#検索ではなくコンパイル
この2年間、LLMに自分の知識を扱わせる標準的な解はRAGだった。文書をベクトルDBに入れ、質問が来たら似たチャンクを探してコンテキストに入れる方式だ。
チャンクの類似度だけを使う基本的なRAGでは、ベクトルDBが見ているのはセマンティックな類似度だけだ。チャンク4271がチャンク8903と矛盾しているか、より新しい研究が8903をすでに覆しているかは分からない。関係を別に保存しないかぎり、チャンクに切った瞬間、文書間の関係は消える。関係をグラフとして前もって抽出しておく変種もあるが、それもまた、関係を質問時点ではなくインジェスト時点に書き留める側へ移ったものだ。
コンパイルはその関係を前もって書き留めておくアプローチだ。質問が来たときに探すのではなく、新しいソースが入ったときにLLMが既存のウィキを読んで関係を直す。矛盾は矛盾として、置き換えられた研究は置き換えられたものとして書き留めておく。
| 項目 | 基本的なRAG | コンパイル |
|---|---|---|
| 前もって作るもの | 検索用のチャンクと埋め込み | 要約、相互参照、矛盾の表示 |
| 保存形式 | ベクトル埋め込み(チャンク) | マークダウン(ページ) |
| 関係表現 | セマンティック類似度 | 明示的な相互参照 |
Karpathyのウィキはテーマあたり記事100本、40万語だ。丸ごとコンテキストに入れるには大きいが、index.mdで見渡して必要なページだけ読むには十分に小さい。彼は複雑なRAGが必要になると思っていたが、LLMがインデックスファイルと文書の要約を自分で管理するだけで十分だったと言った。
#変曲点
この構造を可能にした変曲点はコンテキストウィンドウではない。Gemini 1.5 Proは2024年2月の時点ですでに100万トークンを提供していたが、それだけでは、ウィキをLLMが自分で直すところまでは来なかった。
三つの前提が順に積み重なった。コンテキストウィンドウが広がってindex.mdとページ数枚を一度に読めるようになり、マークダウンがLLMの基本フォーマットになって変換なしに読み書きできるようになった。その上に、Claude CodeやCodexのようなエージェントがファイルを直接操作するようになった。読むこと、読み書きすること、読み書きして維持すること。
決定的なのは三つ目だ。エージェント以前、LLMは自分の文書を読むことはできても、複数のファイルを直してその作業を繰り返すことはできず、ウィキの保守はいつも人の仕事だった。ファイルシステムのAPIが開いて初めて、ウィキはLLMの管轄に移った。
同じ方向へ進んだのはKarpathyだけではない。Shopify CEOのTobi Lütkeは、全文検索とベクトル検索とLLMのリランキングを束ねたローカルのマークダウン検索エンジンqmdを公開した。コンパイルが知識のあいだの関係を前もって整理するなら、qmdはそのマークダウンファイルから必要な内容を探す役割を担う。『Building a Second Brain』の著者Tiago Forteは、2026年に個人の知識管理を個人のコンテキスト管理として定義し直した。AIにどの情報をいつ渡すかを設計するという点で、このウィキと接している。
限界は二つある。一つは正確さだ。リントが矛盾をどれだけ捕まえ、どれだけ見逃すのか、間違った要約がウィキに入ったときにどう広がるのかは、Karpathyも数字で示しておらず、私もまだ測れていない。もう一つは規模だ。index.mdと必要なページがコンテキストに収まる間はコンパイルで十分で、その線を越えればqmdのような検索がまた必要になる。その線まではベクトルDBも独自のAPIも要らず、LLMにはファイルシステムで十分だ。
#参考資料
- Andrej Karpathy、LLM Knowledge Bases (X)。トークン使用がコードから知識へ移りつつあると書いた元のポスト。
- Karpathy、llm-wiki Gist。
CLAUDE.mdとindex.md、log.mdでウィキを維持する構造を収めた公開メモ。 - Hacker News、LLM Wiki討論。ポストが上がった後に上位に上がったコミュニティのスレッド。
- Tiago Forte、Introducing The AI Second Brain。個人の知識管理を個人のコンテキスト管理として定義し直した記事。
- qmd by Tobi Lütke。全文検索とベクトル検索とLLMのリランキングを束ねたローカルのマークダウン検索エンジン。