LLM의 토큰이 코드에서 지식으로 옮겨가고 있다. 2026년 4월 3일 Andrej Karpathy가 X에 올린 포스트는 며칠 만에 Hacker News 상위에 올랐다. 그는 LLM으로 관심 주제의 개인 지식 베이스를 만들고 있다면서 이렇게 적었다.
최근 내 토큰 사용량의 상당 부분이 코드를 다루는 데서 지식을 다루는 쪽으로 옮겨가고 있다.
#세 디렉토리와 세 동작
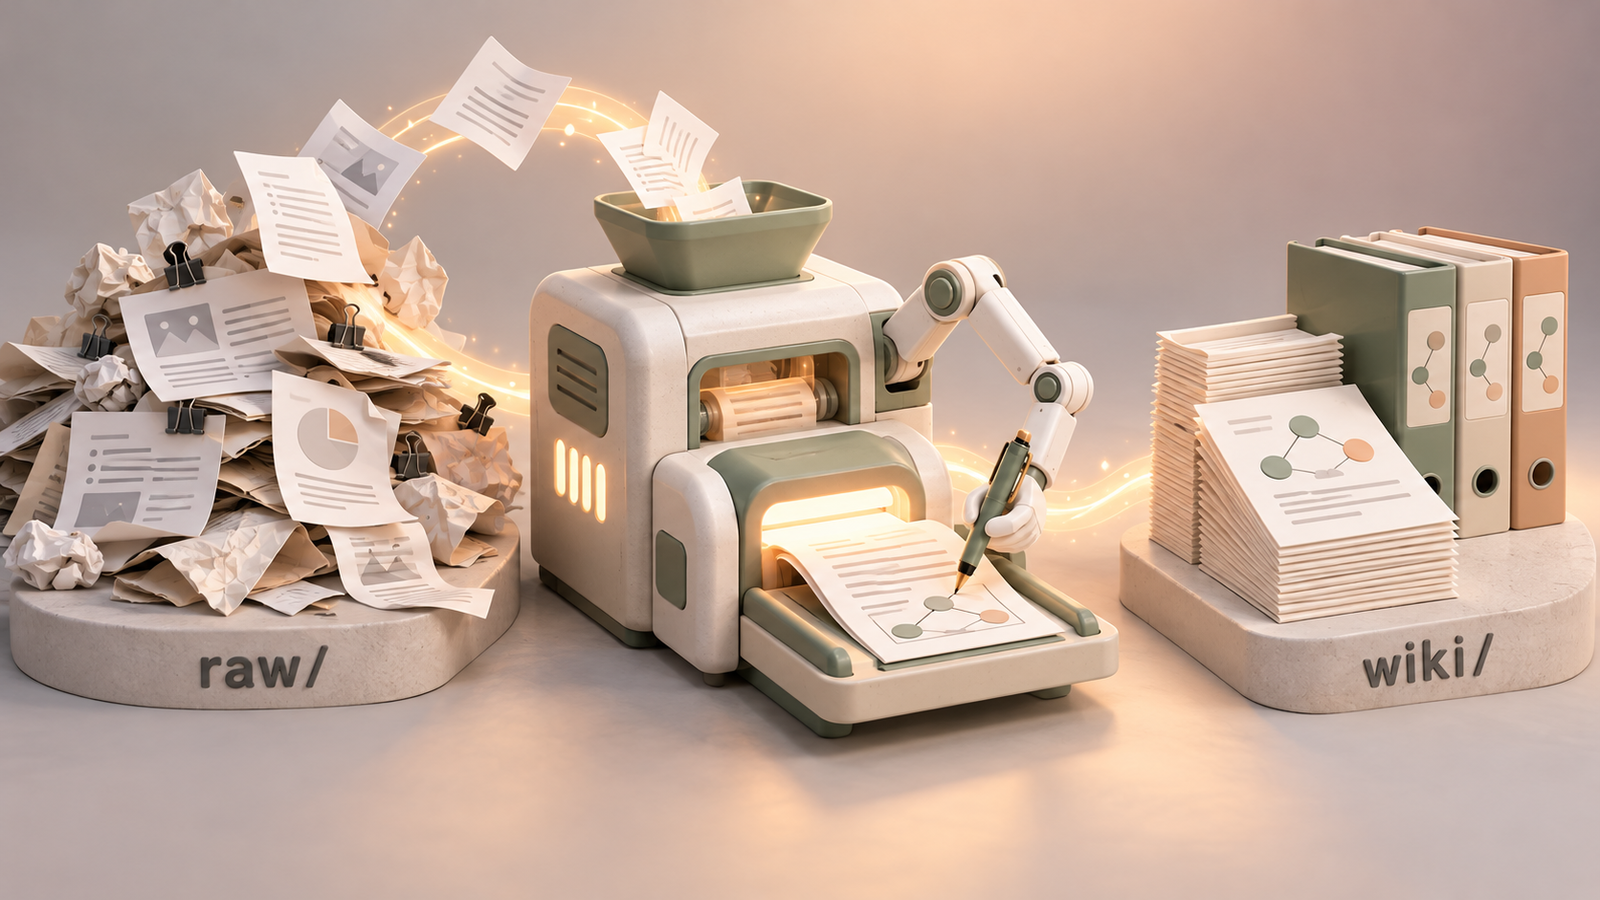
그의 시스템은 raw, wiki, output 세 디렉토리로 나뉜다. 소스 코드에서 바이너리를 뽑아내듯 LLM이 원시 자료에서 구조화된 지식을 뽑아내는 구조다.
raw에는 웹 기사, PDF, 데이터셋, 논문을 있는 그대로 두고 한 번 넣으면 고치지도 지우지도 않는다. 모든 컴파일의 기반이라 원본을 잃으면 다시 만들 수 없기 때문이다. wiki에는 개념 페이지, 엔티티 프로필, 요약, 교차 참조가 쌓인다. 중심에는 모든 페이지의 한 줄 요약을 모은 index.md와 언제 무엇이 들어왔는지 적는 추가 전용 연대기 log.md가 있다.
구조는 Gist에 공개돼 있고, CLAUDE.md나 AGENTS.md가 LLM에게 위키의 구조와 작업 순서를 지시한다. 이 스키마를 쓰는 것은 곧 내 도메인을 어떻게 구조화할 것인가를 정하는 일이다.
위키가 한 번 만들어지고 끝나는 문서 모음이었다면 정적 아카이브에 그쳤을 것이다. 이 시스템이 다른 것은 세 동작이 반복되면서 위키가 계속 바뀌기 때문이다.
- 인제스트: 새 소스를
raw에 넣으면 LLM이 읽고 요약한 뒤 관련 페이지를 고친다. 소스 하나가 10개에서 15개 페이지에 닿기도 한다. 그는 Obsidian Web Clipper로 웹 기사를 마크다운으로 바꿔 넣는다. PDF는 Docling이나 Marker 같은 변환기를 거치면 된다. - 쿼리: 위키에 질문을 던지면 LLM이
index.md에서 관련 페이지를 찾아 읽고 교차 참조하며 답을 합성한다. 답변, 슬라이드, 차트가output에 쌓이고, 쓸 만한 결과는wiki로 되돌려 넣는다. - 린트: LLM이 위키 전체를 훑어 페이지 사이의 모순, 빠진 교차 참조, 오래된 정보, 새 글 후보를 찾아낸다. 코드에 린터가 있듯 지식에도 린터가 있다.
인제스트로 지식을 넣고, 쿼리 결과를 위키에 보태고, 린트로 오류를 고친다. 이 순환이 반복될수록 위키는 정적 아카이브에서 살아 있는 시스템으로 바뀐다.
#검색이 아니라 컴파일
지난 2년 동안 LLM에게 내 지식을 다루게 하는 표준 해법은 RAG였다. 문서를 벡터 DB에 넣고, 질문이 들어오면 유사한 청크를 찾아 컨텍스트에 넣는 방식이다.
청크 유사도만 쓰는 기본 RAG에서 벡터 DB가 보는 것은 시맨틱 유사도뿐이다. 청크 4271이 청크 8903과 모순되는지, 더 최신 연구가 8903을 이미 뒤집었는지 모른다. 관계를 따로 보존하지 않는 한, 청크로 자르는 순간 문서 사이의 관계가 사라진다. 관계를 그래프로 미리 뽑아 두는 변형도 있는데, 그것 역시 관계를 질문 시점이 아니라 인제스트 시점에 적어 두는 쪽으로 옮겨 간 것이다.
컴파일은 그 관계를 미리 적어 두는 접근이다. 질문이 올 때 찾는 게 아니라 새 소스가 들어올 때 LLM이 기존 위키를 읽고 관계를 고친다. 모순은 모순으로, 대체된 연구는 대체된 것으로 적어 둔다.
| 항목 | 기본 RAG | 컴파일 |
|---|---|---|
| 미리 만드는 것 | 검색용 청크와 임베딩 | 요약, 교차 참조, 모순 표시 |
| 저장 형식 | 벡터 임베딩 (청크) | 마크다운 (페이지) |
| 관계 표현 | 시맨틱 유사도 | 명시적 교차 참조 |
Karpathy의 위키는 주제당 기사 100개, 40만 단어다. 통째로 컨텍스트에 넣기에는 크지만, index.md로 훑고 필요한 페이지만 읽기에는 충분히 작다. 그는 복잡한 RAG가 필요할 줄 알았지만 LLM이 인덱스 파일과 문서 요약을 스스로 관리하는 것으로 충분했다고 했다.
#변곡점
이 구조를 가능하게 한 변곡점은 컨텍스트 윈도우가 아니다. Gemini 1.5 Pro는 2024년 2월에 이미 100만 토큰을 제공했고, 그것만으로는 위키를 LLM이 스스로 고치는 일까지 오지 않았다.
세 전제가 순서대로 쌓였다. 컨텍스트 윈도우가 넓어져 index.md와 페이지 여러 장을 한 번에 읽게 됐고, 마크다운이 LLM의 기본 포맷이 되어 변환 없이 읽고 쓰게 됐다. 그 위에 Claude Code와 Codex 같은 에이전트가 파일을 직접 조작하게 됐다. 읽기, 읽고 쓰기, 읽고 쓰고 유지보수하기.
결정적인 것은 세 번째다. 에이전트 이전까지 LLM은 내 문서를 읽을 수는 있어도 여러 파일을 고치고 그 일을 반복하지는 못했고, 위키의 유지보수는 언제나 사람의 몫이었다. 파일시스템 API가 열리면서 비로소 위키가 LLM의 관할로 넘어갔다.
같은 쪽으로 간 사람이 Karpathy만은 아니다. Shopify CEO Tobi Lütke는 풀텍스트 검색과 벡터 검색과 LLM 리랭킹을 묶은 로컬 마크다운 검색 엔진 qmd를 공개했다. 컴파일이 지식 사이의 관계를 미리 정리한다면, qmd는 그 마크다운 파일에서 필요한 내용을 찾는 역할을 맡는다. 세컨드 브레인의 저자 Tiago Forte는 2026년 개인 지식 관리를 개인 컨텍스트 관리로 다시 정의했다. AI에게 어떤 정보를 언제 줄지 설계한다는 점에서 이 위키와 맞닿는다.
한계는 둘이다. 하나는 정확도다. 린트가 모순을 얼마나 잡고 얼마나 놓치는지, 틀린 요약이 위키에 들어갔을 때 어떻게 퍼지는지는 Karpathy도 숫자로 내놓지 않았고 나도 아직 재지 못했다. 다른 하나는 규모다. index.md와 필요한 페이지가 컨텍스트에 들어가는 동안은 컴파일로 충분하고, 그 선을 넘으면 qmd 같은 검색이 다시 필요하다. 그 선까지는 벡터 DB도 독자적인 API도 필요 없고, LLM에게는 파일시스템으로도 충분하다.
#참고 자료
- Andrej Karpathy, LLM Knowledge Bases (X). 토큰 사용이 코드에서 지식으로 옮겨가고 있다고 적은 원문 포스트.
- Karpathy, llm-wiki Gist.
CLAUDE.md와index.md,log.md로 위키를 유지하는 구조를 담은 공개 메모. - Hacker News, LLM Wiki 토론. 포스트가 올라온 뒤 상위에 오른 커뮤니티 스레드.
- Tiago Forte, Introducing The AI Second Brain. 개인 지식 관리를 개인 컨텍스트 관리로 다시 정의한 글.
- qmd by Tobi Lütke. 풀텍스트 검색과 벡터 검색과 LLM 리랭킹을 묶은 로컬 마크다운 검색 엔진.